Anthropicは2026年11月9日、「Claude Fable 5.2」を公開しました。すでにChatGPT、Gemini、Claudeなどを使っている人にとっての判断点は、今の構成で手間がかかる仕事を、追加の費用や待ち時間に見合う形で任せられるかです。公式発表
先に、利用判断に関わるポイントをまとめます。
- Artificial Analysisの総合指数では、最大推論設定のFable 5.2が首位。 APIの公式推奨はhighを基準に評価すること。費用重視ならmediumでも必要な品質を保てるかを比べたいところです。
- まず考えたいのは、難しい開発や複数工程の調査への追加。 Anthropicも普段の主力にはOpus 5.5を勧めています。Fableを毎回使う以外に、難所で切り替える、相談役に加える使い方があります。
- 週の利用枠の50%という上限は残っています。 Max・Ultraなどでは通常の契約に含まれますが、Pro・Teamのスタンダードシートは発売記念の期間を除き、追加の従量課金です。
以下、2026年11月10日時点の公開資料から、性能、使いどころ、利用条件の順に見ていきます。本記事は公開資料の比較であり、編集部による実機レビューではありません。
料金や週50%の上限を先に確認したい方へ: 後半の「どのプランで使える? 通常条件と期間特典を分けて確認」で、プラン別料金、利用枠、期間限定特典、APIクレジットをまとめています。
外部評価ではどのくらい強い? 上位設定とmedium・highを分けて比較
Artificial Analysis(AA)は、複数の試験をまとめた「Intelligence Index」でモデルを比較しています。以下の2表は、2026年11月10日に確認したv5.0.1の公開値です。highやmaxは、問題を解くためにどれだけ計算するかを調整する推論強度を表します。
各モデルの上位設定で比較
まず、AAに掲載された各モデルの最上位設定を比べます。Gemini 4 Carbonは掲載されているlow・medium・highのうちhighを採用しています。各社の設定名は、同じ計算量を意味しません。Carbonの設定別評価
| モデルと推論設定 | 総合指数 | 評価1課題当たりの加重平均費用 | 同・推定時間 |
|---|---|---|---|
| Fable 5.2 max | 65 | 26.54ドル | 46.4分 |
| Gemini 4 Carbon high | 60 | 7.76ドル | 26.4分 |
| Opus 5.5 max | 59 | 10.04ドル | 25.2分 |
| GPT-6 Astra max | 57 | 6.24ドル | 22.8分 |
| GPT-6.1 Sol max | 55 | 1.27ドル | 19.5分 |
| GPT-6.1 Terra max | 51 | 0.96ドル | 13.5分 |
普段使いを考えるmedium・high比較
次はFable、Astra、Opusをmediumとhighで比べます。「普段使い」は本記事で選んだ比較の切り口で、各サービスの標準設定を並べた表ではありません。同じhighという名前でも、費用や待ち時間は異なります。
| モデルと推論設定 | 総合指数 | 評価1課題当たりの加重平均費用 | 同・推定時間 |
|---|---|---|---|
| Fable 5.2 medium | 56 | 3.80ドル | 8.3分 |
| Fable 5.2 high | 62 | 9.08ドル | 17.7分 |
| GPT-6 Astra medium | 52 | 2.73ドル | 6.8分 |
| GPT-6 Astra high | 55 | 3.24ドル | 9.9分 |
| Opus 5.5 medium | 48 | 2.45ドル | 7.2分 |
| Opus 5.5 high | 52 | 3.46ドル | 9.5分 |
high同士ではFableの指数が高い一方、評価費用と推定時間もAstra・Opusより大きくなっています。上位設定での順位だけで選ぶより、今のモデル・設定で足りない品質を、どの程度の追加負担で補えるかを考える材料になります。
出典:AAのモデル比較と各モデルページ。両表の費用は、API単価やキャッシュ条件を反映した評価1課題当たりの加重平均です。推定時間も課題の出力トークン量と生成速度からの計算で、速度・遅延の測定値には直近5日間の平均が使われます。通常の質問1回の請求額、定額プランの料金、ClaudeやChatGPTアプリでの実測時間ではありません。 同じ予算にそろえた比較でもありません。
FableとOpusの各行は「Default Fallback」と記載された構成です。代替モデルへの切り替えを許す条件で、元のモデルだけを固定して測った値とは区別が必要です。実際の切り替え回数・内訳は、今回確認した公開ページでは分かりませんでした。ほかの掲載モデルにはこの表記を確認できませんでしたが、切替処理が一切ないと保証するものではありません。Fable highの評価条件、Opus highの評価条件
AAの指数は知識業務、コーディング、科学、一般分野を組み合わせたものです。v5.0.1は9評価で構成され、各分野の重みは25%。指数は整数表示なので小差を読み過ぎず、個別の用途も後段で確認してください。旧版の指数で測られたFable 5や5.1の数字を、そのまま差し引いて進歩率を出すことはできません。AAの指数の定義
どのeffortが割に合う? 公式の基準と費用重視の選び方
effortは、回答やツール操作のためにどれだけ考えるかを調整する設定です。Fable 5.2ではlow、medium、high、xhigh、maxの5段階があります。ここでは、Fableを使うと決めた仕事の推論強度を比較します。
AnthropicのAPI向け推奨は、既定値のhighから始め、自分の評価で上下を調整することです。Claudeアプリ・Claude Codeの既定値はmediumで、利用場所によって出発点が異なります。本記事ではAAの費用・時間も踏まえ、対話的な作業ならmediumで十分かも比べる、という目安を示します。API向けの公式推奨、アプリ・Codeの既定値
AAで同じモデルの5段階を並べると、次のようになります。上の主要モデル比較と同じ、2026年11月10日時点のIntelligence Index v5.0.1、Default Fallbackの値です。
| effort | 総合指数 | 評価1課題当たりの加重平均費用 | 同・推定時間 |
|---|---|---|---|
| low | 54 | 3.10ドル | 6.5分 |
| medium | 56 | 3.80ドル | 8.3分 |
| high | 62 | 9.08ドル | 17.7分 |
| xhigh | 62 | 14.83ドル | 26.3分 |
| max | 65 | 26.54ドル | 46.4分 |
費用は、評価課題で使った入力・出力・推論トークンなどを、API単価とキャッシュ条件に基づいて換算した加重平均です。時間も出力トークン量と測定した生成速度などからの推定で、Claudeアプリで同じ作業を実行した所要時間ではありません。単価そのものではなく、考える量を増やした結果、作業当たりの費用と時間がどう変わったかを見る指標です。AAの費用・推定時間の定義
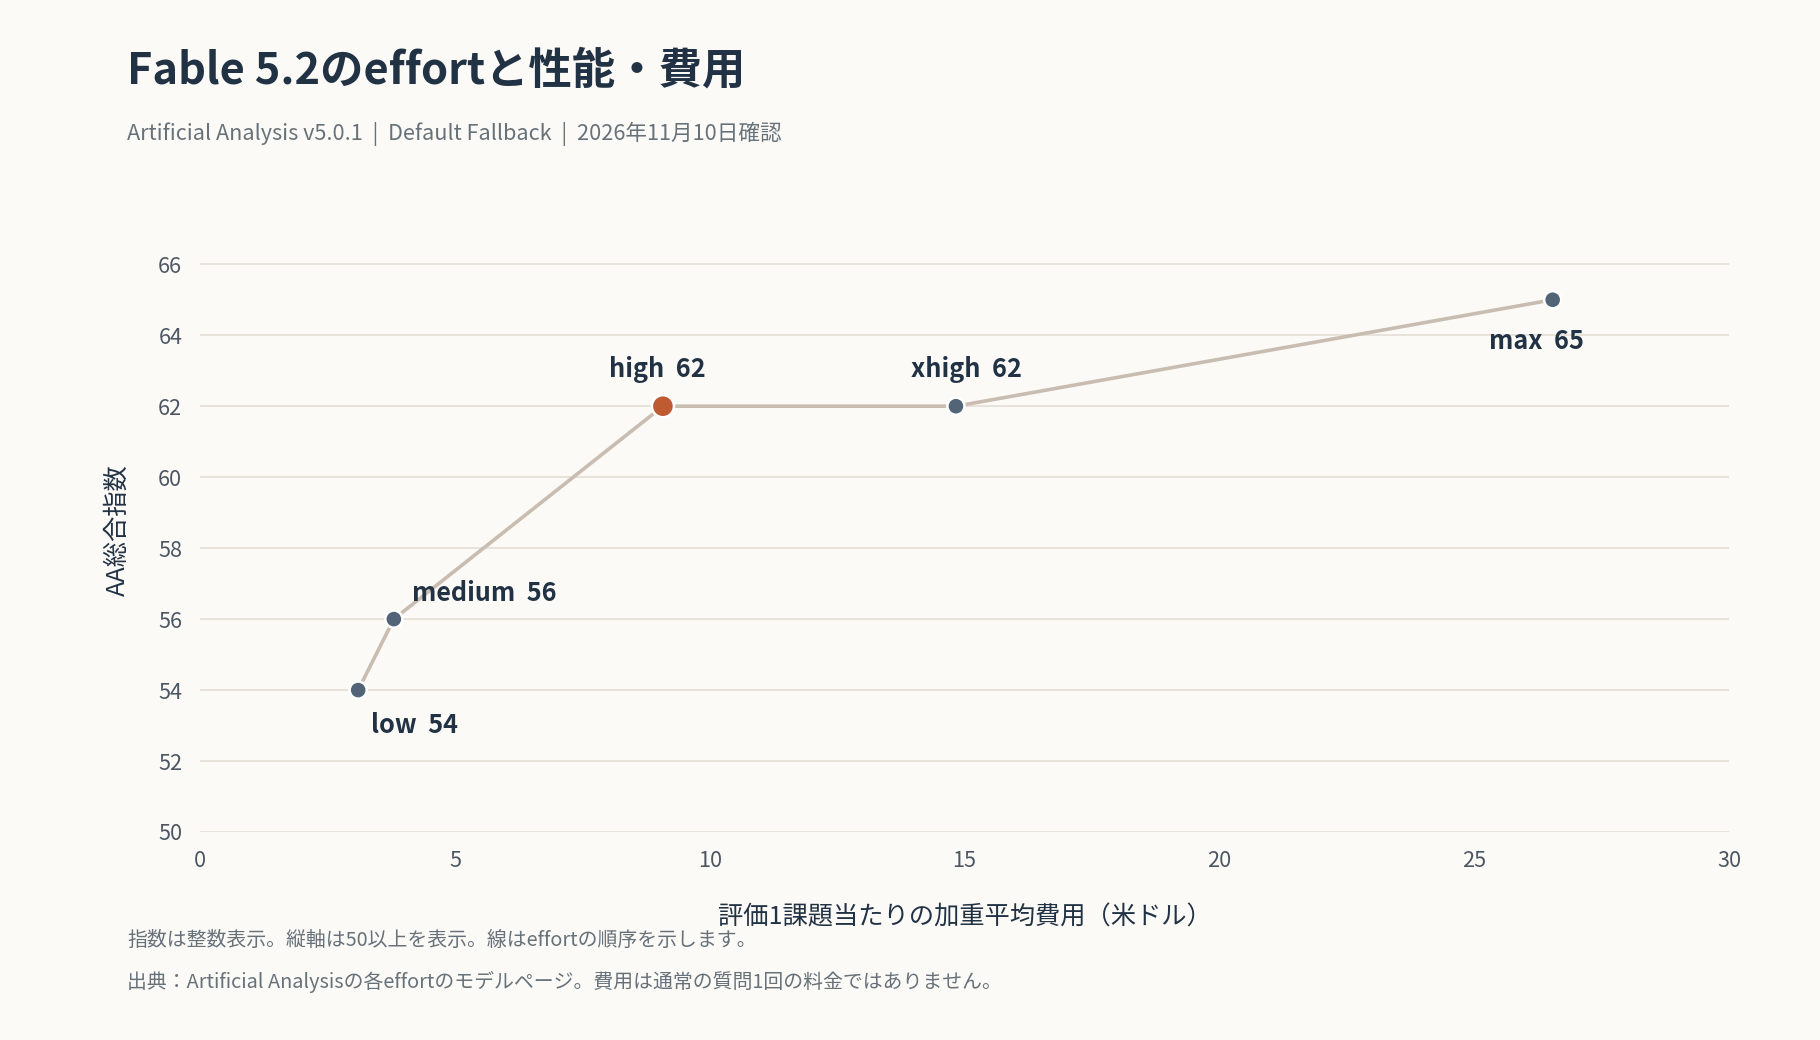
AA公開値から作図。縦軸は50以上を表示しています。線はeffortの順序を示すもので、途中の費用で同じ性能を買えるという意味ではありません。
highから先は、改善幅を確かめて上げたい
表示値から増分を計算すると、設定ごとの違いが見えてきます。
- low → medium:指数は2点上昇。 費用は約23%増、推定時間は約28%増です。
- medium → high:指数は6点上昇。 伸びは大きい一方、費用は約2.39倍、推定時間は約2.13倍になります。
- high → xhigh:整数表示ではどちらも62。 費用は約63%増、推定時間は約49%増です。
- xhigh → max:指数は3点上昇。 費用は約79%増、推定時間は約76%増です。
mediumはhighより評価費用が約58%低く、推定時間も約53%短くなります。highはmaxより指数が3点低い一方、評価費用は約66%低く抑えられます。費用を抑えたい対話作業ではmediumも比較し、難しい開発や長時間の自動処理ではhighを基準にする、というのが本記事の提案です。mediumをすべての利用場面での公式推奨と受け取らないようにしてください。
ただし、これは「highが誰にとっても最良」「xhighには効果がない」という意味ではありません。指数は整数に丸められた複数分野の集計値です。個別の難しい仕事では差が出る可能性があり、実際にAnthropicの自己報告では、開発評価FrontierCode 2.0がhighの45.3%からxhighの49.1%へ上がっています。この数値は独立評価とは分けて読む必要があります。公式の用途別評価
また、AAの同じ一覧ではOpus 5.5のmediumが指数48・2.45ドル、highが52・3.46ドルです。mediumからhighへの費用増は約41%で、Fableの約139%とは違います。Opusでhighを常用していた人も、Fableでは同じ設定が自分に合うとは限りません。
用途別に選ぶなら
以下は公開評価と公式ガイドを踏まえた、試し始める設定の目安です。これらの用途すべてを、編集部が各設定で実測した結果ではありません。
- low:短い確認や手順が決まった軽作業。 応答の速さを優先し、人がすぐ結果を確認できる仕事で試します。mediumより評価費用は約18%低いものの、安さだけで複雑な仕事まで任せないようにします。
- medium:対話しながら進める調査、文章の推敲、範囲の小さい修正。 ClaudeアプリとClaude Codeの標準設定です。まずこれで完成条件を満たせるかを見ます。
- high:難しい不具合、複数ファイルの改修、複数資料を突き合わせる調査。 mediumで見落としややり直しが増える仕事の候補です。
- xhigh:highでも詰まる、長い推論や検証が必要な課題。 自分の課題で改善を確認してから常用するかを決めます。
- max:費用や待ち時間より、難問での到達点を優先する場合。 highからは評価費用が約2.92倍、推定時間が約2.62倍になるため、普段の初期設定にするより、用途を絞る方が現実的です。
どこで変更できる? 契約プランとeffortは別の設定
| 利用場所 | 変更方法と注意点 |
|---|---|
| Claudeアプリのチャット | モデル名のメニューから「Effort」を開いて選択。Fable 5.2の標準はmediumです。組織では管理者設定により選べる項目が制限される場合があります |
| Claude Code | 「/effort high」などで指定、または「/effort」の選択画面で変更。Fable 5.2の標準はmedium。maxは原則そのセッション限りで、管理設定や環境変数による制限・上書きもあります |
| API | 「output_config.effort」で5段階を指定。指定しない場合の標準はhighです。API利用は別の従量課金で、Claudeの月額プランの利用枠とは分けて考えます |
出典:チャットでの変更、Claude Codeの設定、APIのeffort仕様。
契約プランはFableを利用できるか、料金にどの枠が含まれるかを決めるもので、effortは使う際の推論強度です。「Maxプラン」と「max effort」も別の概念です。Fable 5.2は低いeffortでも思考を行い、effortは使用トークン数の厳密な上限を指定する機能ではありません。
AAの費用が58%下がるから、定額プランの週次枠も58%節約できる、とは計算できません。 実際の消費は会話の長さ、資料、ツール操作、やり直しにも左右されます。低い設定で何度も依頼し直すと、最初からhighで完了させる方が少ない消費で済むこともあります。
まず自分が繰り返す仕事を選び、今の構成を基準にしたうえで、Fableのmediumとhighを同じ資料・指示の新しい会話で比べます。完成条件を満たしたか、完了までの時間、実際の利用量、人の手直しを確認し、必要な品質が出る低い設定を選びます。公式の比較の進め方
得意な仕事は? コードの難所には期待、資料作成は使い分け
別の独立評価機関Vals AIも、Fable 5.2を高く評価しています。11月9日公表のVals Index v2.2では71.31%で首位でした。ただしSonnet 5.5は70.85%、Gemini 4 Carbonは70.45%と近く、Fableの表示誤差は±0.96です。「大きく引き離した」とは言いにくい結果です。
Valsの基本条件はAnthropic API、推論high、最大出力128,000トークン。代替モデルへの切り替えも1.88%報告されており、試験によって設定が異なる場合があります。Valsによる評価と測定条件
開発:新規作成だけでなく、移行や複雑な修正の候補
ValsのVibe Code Bench v1.1では、文章の仕様からWebアプリを作るOpenHands構成で93.77%と首位でした。GPT-6 Astraは89.59%、GPT-6.1 Terraは84.00%です。Vibe Code Bench
Terminal-Bench 4.0も65.15%でOpus 5.5と同率首位。この試験はコマンド操作で66課題に取り組むmini-swe-agent構成で、1課題最大8時間、3回の単独試行の平均です。同じ一覧では旧Fable 5が41.41%、5.1が58.08%で、世代間の改善も見られます。Terminal-Benchの条件
一方、画面なども扱うSWE-bench Multimodalは62.29%で、Opus 5.5の70.21%に届いていません。開発でも課題や実行環境による違いがあります。Valsの用途別結果
これを実務に置き換えるなら、「普段のAIで修正を繰り返しても解決しない不具合」「複数ファイルにまたがる改修」「古い仕組みから新しい仕組みへの移行」が比較候補になります。これは評価を踏まえた活用案で、自社のコードで同じ成功率を保証するものではありません。最初は既存のテストがある作業を選び、変更の正しさとレビュー時間を比べると判断しやすくなります。
資料・表計算:総合首位だから一律に置き換える、とは考えない
AAの「Briefcase v1.1」は、資料を読んで表計算、スライド、メモなどを作る91課題の評価です。Fable 5.2 maxは1785 Eloで3位。Sonnet 5.5 maxの1813、Opus 5.5 maxの1801が上でした。このEloは、採点基準の達成度と成果物同士の比較を合わせた相対指標で、完成度の百分率ではありません。AA-Briefcase
別の仕事評価GDPval-AA v2.1でも、Fable 5.2 maxは1831 Elo、Opus 5.5 maxは1866でした。こうした評価は使う道具や採点方法で順位が変わりますが、少なくとも「資料作成でもFableが常に最良」という根拠にはなりません。GDPval-AA
毎週の集計表や定型資料が今のモデルで十分なら、そのまま使い、複数資料の食い違いを調べる、原因を掘り下げるといった難所だけFableに任せる方法が考えられます。
科学・専門業務:強みはあるが、分野ごとの確認が必要
ValsのScience Indexでは63.74%で2位、GPT-6 Astraは65.09%でした。法務系のLegal Indexは20位、Tax Agent Benchは27位で、総合性能の高さがすべての専門業務に当てはまるわけではありません。これらを日本の法務・税務の正確さとして読むこともできません。Valsの分野別評価
Fable 5.2と同時に発表されたMythos 5.2は同じ基盤モデルですが、サイバー・生物分野の安全対策と提供条件が異なります。承認された組織向けのMythosの成果を、そのまま一般向けFableでできることとして扱わないようにします。FableとMythosの違い
PC操作はAstraよりすごい? 公式の数値と独立評価の境界
Anthropicの発表表では、PC操作の「OSWorld 2.1」でFable 5.2が89.3%、Fable 5.1が83.5%、Opus 5.5が87.2%、GPT-6 Astraが79.5%、Gemini 4 Carbonが81.5%でした。
ただし、これはAnthropicが掲載した「offline set, partial」という限定条件の結果です。原則として各モデルの利用可能な最大推論設定で比較されています。今回確認した資料では、この比較の独立した再現結果は確認できませんでした。「手元のPC操作でもAstraより確実に優れる」とまでは断定できません。公式の比較表と脚注
また、PC操作を含む業務の実行性能は、モデル以外にも、利用するアプリ、操作ツール、権限、途中確認の仕組みに左右されます。APIではFable 5.2のcomputer useに対応するツール構成が必要で、旧来のツール指定をそのまま使うと、Amazon Bedrock以外ではエラーになる変更もあります。モデル名だけを差し替えれば、既存の自動化がそのまま改善するとは限りません。Fable 5.2の変更点
PC操作を比べたいなら、まず「受領した資料から一覧を作る」「確認用の入力下書きを作る」など、結果を照合できる作業で試すのが現実的です。送信・支払い・正式登録を含める前に、人が確定する箇所を決めておきます。関連する考え方は、AIの作業報告と承認記録を確認するガイドで整理しています。
今のAI構成に、どの役割で足すか
Anthropicは、多くの開発・知識業務ではOpus 5.5から始め、仕事の規模や難しさに応じてFableへ切り替える使い方を勧めています。API向けの説明では、Opusを高いeffortで使っても自社の評価基準を満たさない場合が、Fableを検討する目安です。発表での位置づけ、APIでのモデル選択
ChatGPTやGeminiを主力にしている人も、比較対象は「今使っているモデル・設定・道具の組み合わせ」です。以下は、その構成を生かしながらFableを試す案です。
- 難所だけ直接任せる。 今のAIで修正を繰り返す不具合、結論がまとまらない調査などを一つ選び、Fableに同じ資料と完成条件を渡します。普段の資料作成まで一斉に置き換える必要はありません。
- Claude Codeの相談役に加える。 実作業をHaiku・Sonnet・Opusなどに任せ、難しい判断でFableへ相談する実験的機能「Advisor」があります。相談分も利用量に計上されます。仕組み、設定・解除、対応する接続経路、費用の見方は、Advisorの使い方ガイドにまとめました。公式の提供条件
- 独自エージェントの主担当にする。 Fableが計画・判断を担い、簡単な作業を小型モデルへ委任する「Orchestrator」の構成です。公式発表が案内するManaged Agentsの複数エージェント機能はベータで、モデルを指定した子エージェントなどの設計が必要です。通常のClaudeチャットの切替項目ではありません。既存のAPIアプリには、実作業側から相談するAdvisor toolもあります。Managed Agentsの構成、APIのAdvisor tool
Advisorでは、相談分も主モデルとは別に利用量へ計上されます。サブスクリプションではプランの枠を使い、Fableが従量課金となる契約ではusage creditsを消費します。小型モデル単独より総費用が下がるとは限らないので、相談で減ったやり直しと、増えた利用量を一緒に比較します。Managed Agentsでは複数モデルの合計使用量に加え、セッション実行時間やツールの費用も確認します。Advisorの費用、Managed Agentsの料金
どのプランで使える? 通常条件と期間特典を分けて確認
ClaudeアプリでのFable 5.2は有料プラン向けです。ただし「選択できる」と「月額料金の範囲で使える」は別です。
| プラン | 米ドルの基本料金・税別 | Fableの通常の扱い |
|---|---|---|
| Free | 無料 | 利用不可 |
| Pro | 月払い20ドル。年払い200ドル | 使用量に応じたusage creditsで利用 |
| Max | 月100ドル | 週の利用枠の50%まで含む |
| Ultra | 月200ドル | 週の利用枠の50%まで含む |
| Team(スタンダードシート) | 月払い25ドル/シート。年払いは月換算20ドル/シート | usage creditsで利用 |
| Team(プレミアムシート) | 月払い125ドル/シート。年払いは月換算100ドル/シート | 週の利用枠の50%まで含む |
Teamは2シートからのプランです。Enterpriseは契約方式で異なり、旧来のシート単位契約ではプレミアムシートに50%枠、スタンダードシートはusage credits。使用量ベースの契約はAPI料金で課金されます。現在のセルフサービスEnterpriseは年契約・最低20シートで、1シート月20ドルに使用料が加わります。料金表、Fableのプラン別条件
「50%」の母数はプランごとに違う
50%の母数は、その契約に付く全モデル共通の週次利用枠です。料金表では、Maxの全体週次枠はProの5倍、UltraはProの10倍。したがって同じ50%でも、UltraのFable枠はMaxの2倍の大きさになります。ただし、これは枠の比率であり、質問回数、処理できる文字数、API料金への換算ではありません。通常のProはFableが契約枠に含まれないため、「MaxならProの5倍Fableを使える」とも読めません。公式の利用量比較
Maxは5時間ごとの枠もProの5倍です。Ultraで5時間制限がなくなるのは検証済みアカウントで、週次枠は残ります。検証はアカウントや決済履歴などに基づく自動判定です。Ultraの条件
Fable 5.2、5.1、5は共通のFable枠を使います。モデルを切り替えるたびに別々の50%枠がもらえるわけではありません。
たとえば週の利用枠を100とすると、Fableに使えるのは最大50です。Fableで40、ほかのモデルで60を使えば、合計100に達します。残りのFable枠が10あるように見えても、全体の週次枠が尽きていれば、そのまま追加料金なしで使えるわけではありません。 これは枠の関係を示す例で、100回の質問ができるという意味ではありません。上限の仕組み
FableはほかのClaudeモデルより枠を速く消費します。上限に達したら、残りの全体枠で別モデルを使うか、usage creditsによる追加課金で続ける形です。質問の長さや添付ファイル、実行する作業によって消費量が変わるため、「1週間で何回」と一律には数えられません。料金・利用量の説明
Pro・Teamのスタンダードシートの50%枠は、11月17日夕方までの特典
今回の発売記念では、ProとTeamのスタンダードシートにも全Fableモデルの50%枠が一時的に含まれます。終了は日本時間2026年11月17日16時59分、米太平洋時間11月16日23時59分です。以後は通常の従量課金に戻り、未使用分は持ち越せません。
さらに、所定の条件を満たす既存契約者には「Fable limit reset」が付きます。
- Pro・Teamのスタンダードシート:1回。上記の特典終了時に失効。
- Max・Ultra・Teamのプレミアムシート・旧シート単位契約のEnterpriseのプレミアムシート:課金開始から6か月未満は1回、6〜12か月は2回、12か月超は3回。期限は2027年3月8日23時59分PT。
リセットの対象は、原則として11月9日10時PT、日本時間11月10日3時より前に有料課金が始まった契約です。組織のシートは参加時期にも条件があります。無料試用からの移行などの例外は、公式案内で確認してください。
リセットすると、週次枠のうちFableで消費した分が戻ります。5時間枠のあるアカウントでは、その枠全体も回復します。ただし、50%の上限自体を引き上げる特典ではありません。 「Settings → Usage」の表示を確認して使います。発売記念特典の対象・期限・操作方法
旧Fable 5のPro・Teamのスタンダードシート向け特典は、7月19日PTに終了しています。今回のFable 5.2の特典とは別です。過去の紹介記事を参考にするときは、この日付の違いに注意してください。通常条件と旧特典の説明
今の契約と予算から、試す入口を選ぶ
- Max・Ultraを契約済みなら: まず含まれるFable枠で、普段のAIが苦戦する仕事を比較します。追加課金を前提にする前に、全体枠とFable枠の両方を確認します。
- Pro・Teamのスタンダードシートなら: 今回の期間特典中に用途を絞って試せます。終了後に時々使うならusage creditsの支出上限を決め、継続して多く使うなら上位プランの月額料金と比較します。Teamはシート数・組織管理も含む契約なので、個人向けプランと1シート当たりの料金だけでは比べられません。
- ほかのAIを主力にしており、Claudeの固定費を増やしたくないなら: 技術的に扱える人はAPIの従量利用も候補です。入力・出力だけでなく、推論、再試行、ツールまで含む実支出を記録します。Claudeアプリと同じ操作体験を買うものではない点も判断に入れます。
usage creditsは通常のAPI単価に基づく追加利用で、月額料金とは別請求です。少額で試すつもりなら、開始前に月間支出上限と自動チャージ設定を確認します。追加利用の設定
APIを試す人は、付属クレジットの対象も確認
Maxには月100ドル、Ultraには月200ドルのAPIクレジットがあります。Teamもスタンダードシート20ドル・プレミアムシート100ドル相当を組織で合算しますが、月500ドルが上限です。Proは対象外です。
有効な対象契約で7日経過後、Webの請求設定から申請し、権限のあるConsole組織を連携します。1契約と1組織をひも付ける仕組みで、未使用分は請求周期末に失効し、繰り越せません。
利用可能なClaudeモデルのAPI・Playground・Managed Agentsなどが対象なので、Fableの比較にも使えます。一方、通常の対話型Claude Codeや、Claude・Claude Code・Coworkの追加利用には充当できません。 Bedrockなど他社クラウド経由も対象外です。残高が尽きた後は購入クレジットや自動チャージの有無で継続・停止が変わるため、Console側も確認します。APIクレジットの対象・申請条件
APIの費用と移行で確認したいこと
Fable 5.2の標準API料金は100万トークン当たり入力8ドル・出力40ドルで、5.1の10ドル・50ドルから20%下がりました。一方、Opus 5.5の入力4ドル・出力20ドルと比べると、標準単価は2倍です。トークンは文字や画像などを処理する量の単位で、文字数とは一致しません。APIの文脈上限は100万トークン、最大出力は128,000トークンです。仕様、5.1からの料金変更
Anthropicは通常の出力生成が5.1より最大30%速くなり、別料金のfast modeではさらに最大2.5倍になると説明しています。fast modeは入力16ドル・出力80ドルで標準単価の2倍です。これは提供元の説明であり、調査やツール操作を含む作業全体が同じ割合で終わるという意味ではありません。速度の公式説明
ただし単価2倍から、完了までの総費用も2倍とは決められません。使うトークン量や再試行回数が変わるためです。特にOpus 5.5のAPIからeffort未指定のまま替えると、既定値がmediumからhighへ変わります。比較時にはeffortも記録してください。モデル仕様と既定値
以前のプロンプトを、そのまま最適解にしない
OpusやFable 5.1向けに調整した指示は、Fable 5.2でも効果があるか見直します。常に補助AIへ分担させる指示、過度な短文制約、古い失敗を避けるために積み重ねた禁止事項などは、費用や動作を変えることがあります。medium以上で「考えず即答して」と書くより、effort自体を比較する方が適切です。
まず業務上必要な目的・完成条件・権限の制約を残した短い指示を基準にし、旧モデル向けの調整を一つずつ試します。小さな修正なら、AIにコード全体の所有権を与えるような指示も持ち越さない方がよいでしょう。余分な変更を促す可能性があるためです。変更は新しい会話で試し、送信・削除などに必要な承認条件は維持します。公式の旧プロンプト見直し事項
APIはモデル名だけでなく、履歴とツールも確認
開発担当者が移行するときは、少なくとも次を確認します。
- 生成パラメーター: temperature・top_p・top_kは省略し、thinkingは省略またはadaptiveへ。思考の無効化、固定のbudget_tokens、強制的なtool_choiceのany/tool、assistant prefillなど、旧設定の一部は使えません。
- 会話履歴: thinkingを含む履歴を再送するとき、system・tools・過去の発言を途中で書き換えると、全アカウントに適用される整合性チェックでエラーになる場合があります。古い会話の再開もテスト対象です。
- Advisorの組み合わせ: Fable 5.2を実作業側のモデルにするなら、AdvisorもFable 5.2またはMythos 5.2が必要です。既存の主モデルだけを変えるとエラーになる場合があります。対応する組み合わせ
- 道具とモデル切替: PC操作ツールの版、拒否時の処理、代替モデルへの切替を確認します。Fable 5.2からOpusなどへ戻す際は思考履歴を引き継げず、切替直後の費用や待ち時間が増える場合があります。
詳細は公式の移行ガイドで、利用経路ごとの例外も確認してください。まず既存構成で通るテストを新構成でも実行し、成功率だけでなく、エラー、総費用、待ち時間を比べてから切り替えます。
試す前に確認したい、利用環境とデータの扱い
Fable 5.2はWeb・モバイル・DesktopやCowork、Claude Codeなどで利用できます。表示されなければ、Claude Codeは2.1.321以降、Coworkは最新版のDesktopかを確認します。Team・Enterpriseでは管理者のモデル許可も確認が必要です。利用場所と必要バージョン
業務資料を入れる場合は、Fable 5.2が原則として入力・出力の少なくとも30日間の保存を求める対象モデルである点も確認します。通常のゼロデータ保持設定をそのまま適用できず、例外はAnthropicの明示的な承認などが必要です。顧客情報や非公開コードを扱う組織は、契約と社内ルールに照らして判断してください。対象モデルのデータ保持方針、APIの保持条件
判断をまとめるなら、今の構成で十分な仕事は維持し、やり直しの多い仕事だけFableで比較するのが出発点です。比較メモには、使ったモデル・effort・道具、完了までの時間、消費した枠や追加費用、人の修正時間を残します。
難所が減るなら直接切替やAdvisorとして追加し、多くの工程をまとめて任せる価値が見えたら、主担当にする構成を検討します。改善が小さければ、今の構成を維持する判断もできます。期間限定の50%枠やリセットで試す場合も、特典終了後の費用で続けられるかまで確認して、任せる範囲を決めるとよいでしょう。
情報確認日:2026年11月10日。料金、提供条件、特典、評価値は変わる場合があります。比較表は確認時点の公開値で、同一費用にそろえた比較や、日本語業務全般の実測結果ではありません。