Metaは2026年11月9日、軽量AIモデル「Muse Ember」を公開しました。注目したいのは、最難関の仕事をすべて置き換える能力よりも、分類・情報抽出・コードの小さな修正を何度も実行するときの費用です。
独立評価では、同じ軽量クラスのClaude Haiku 5.5に近い総合性能を、少ない評価費用で示しました。すでに高性能モデルを使っている人にとっては、主力を替えるより「繰り返す部分だけ任せる」候補です。ただし、日本での新規契約条件と月額料金は、今回確認した公開資料だけでは確定できていません。Metaの発表
賢さと費用:Haiku・Lunaと比べるとどうか
Artificial Analysis(AA)の11月9日の評価では、Muse EmberのmaxはIntelligence Indexが36、評価1課題あたり約0.14ドル。Haiku 5.5のmaxと整数表示の指数は同じで、課題あたりの費用は約3分の1でした。これは入力・出力トークン単価が3分の1という意味ではありません。消費するトークンやキャッシュ料金の違いも反映した評価結果です。AAの分析
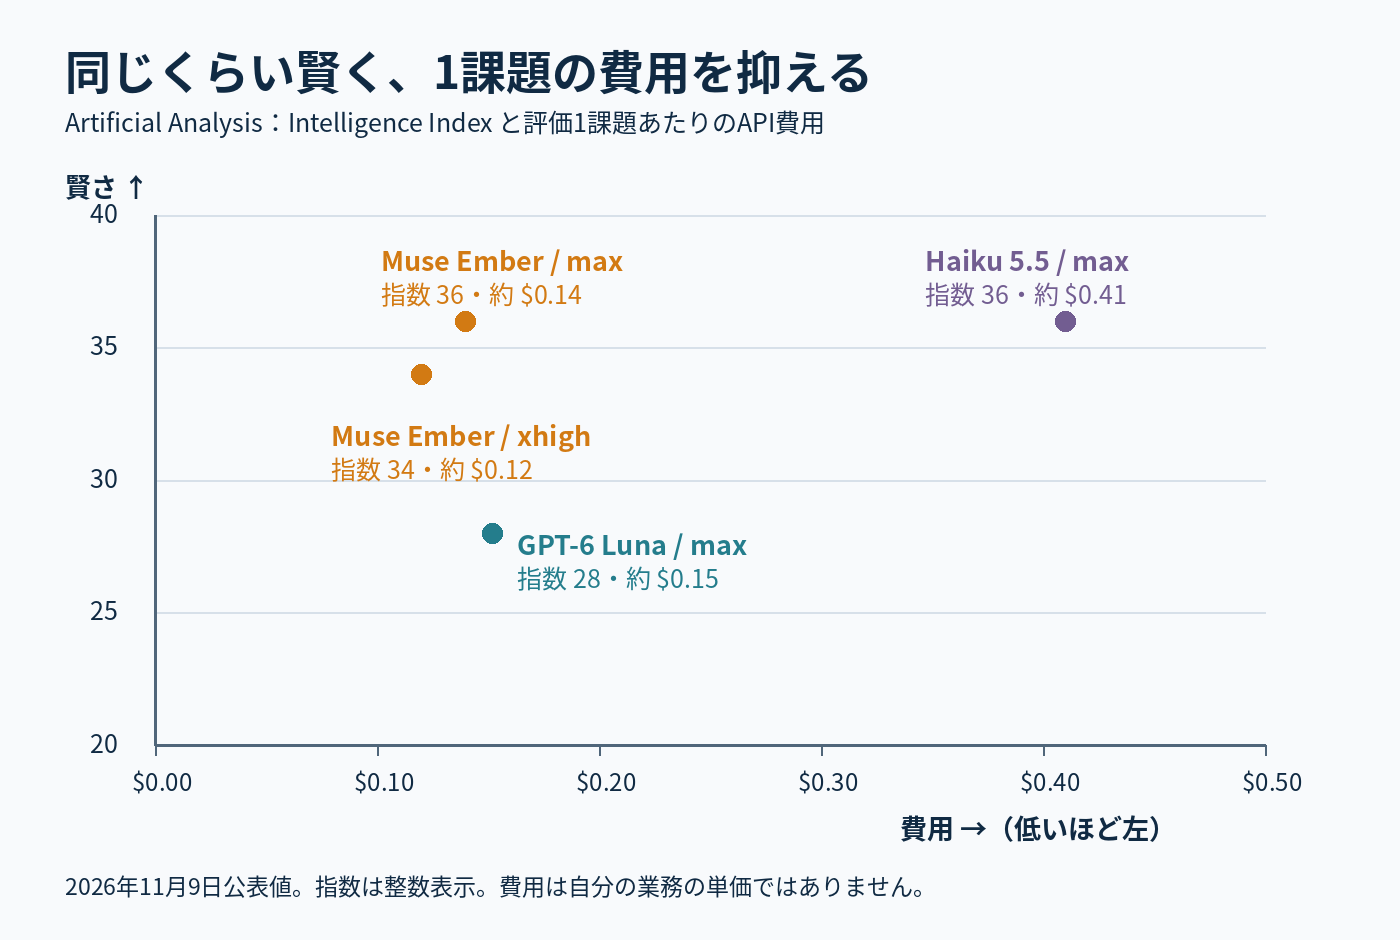
図はAAの公開値と、Metaが転載したAAの数値から作成しています。指数は整数表示であり、小数点以下まで同じではありません。費用はその評価課題の値で、自社の問い合わせ1件やコード修正1回の料金を保証するものではありません。Meta掲載の比較条件
今回は、費用を抑えて多数の処理を回す判断に合わせ、軽量モデルを比較しています。Fable・Opus・Astraなどの最上位モデルを全面的に置き換えられる、という比較ではありません。
Vals AIでも、安さと用途ごとの差を見る
別の評価機関Vals AIは、max設定でVals Index v2.2が60.48%(±1.07)、1テストあたり0.153ドルと報告しています。11月9日の発表時点で、その指数に掲載されたモデルの中で最も低いテスト費用でした。Legal Indexでは75.69%でしたが、法律や税務の専門判断を無確認で任せられることを示す結果ではありません。Vals AIのモデル評価
AAの36とValsの60.48%は、問題も集計方法も違う指標です。数字を横につないで平均したり、自分の業務の成功率として読んだりはできません。ここで見るべきなのは、複数の評価でも低費用という特徴が見え、用途によって得手不得手が残ることです。
どの仕事に追加するか
導入を考えやすいのは、入力と正解の条件をある程度そろえられる作業です。例えば、次のような分担を試せます。以下は公開仕様を踏まえた活用案であり、Secuvistaによる実測結果ではありません。
- 問い合わせの一次分類:請求、障害、機能要望などに振り分け、判断できないものを人へ渡す。
- 文書からの項目抽出:日付や商品名などを所定の形式に整理し、必須項目の欠落を検査する。
- 開発の小さな作業:大きなモデルが作業方針を立て、対象ファイルの確認や限定的な修正をEmberに分担させる。
Metaも、複雑な単発の開発問題や知識を多く要する質問にはSpark・Wonderを、範囲が限定された反復作業にはEmberを挙げています。文字だけでなく画像・音声・動画・PDFを入力できますが、どの入力でも同じ精度になるわけではありません。公式モデルガイド
AAではコーディング評価にも得手不得手があり、知識を問う評価は弱点とされています。資料に答えがある抽出作業と、モデルの知識だけで答える相談は分けて試す方がよいでしょう。返答が短い・速いことだけで、仕事が正しく完了したと判断しないことも大切です。AAの用途別分析
effortはmaxが既定。どの設定から試す?
Meta Model APIでは、Muse Emberの推論設定はminimalからmaxまで選べ、省略時はmaxです。内部で考えるためのトークンも出力側の利用量に含まれ、料金が発生します。noneによる推論の完全無効化には対応しません。公式の推論設定
公開されたAAの比較では、xhighが指数34・約0.12ドル、maxが36・約0.14ドルでした。この範囲ではmaxの追加費用は小さく見えますが、mediumやhighまで含めた性能の伸び方は、今回取得した評価資料からは判断できません。他モデルのhighとEmberのhighが同じ計算量という意味でもありません。
最初は既定のmaxで、普段のモデルと同じ入力を処理させ、品質の基準を作るのが分かりやすい方法です。その後、作業が単純で回数が多い場合にxhighや下位設定を試し、誤り、再実行、人の修正時間まで含めて安くなるかを比べます。これは編集部の試し方の提案で、公式が全用途にmaxを推奨しているという意味ではありません。
API料金:長い会話では単価が変わる
Meta直販APIのStandard modeの料金は次のとおりです。いずれも100万トークンあたり、米ドル表示です。
| 種類 | 入力が20万トークン以下 | 入力が20万トークン超 |
|---|---|---|
| 入力 | $0.10 | $0.30 |
| キャッシュ済み入力 | $0.004 | $0.012 |
| 出力 | $0.50 | $1.50 |
20万の判定にはキャッシュ済み入力や、継続する会話の履歴も含まれます。超えた場合は超過した部分だけでなく、そのリクエスト全体に長文向けの単価が適用されます。1Mトークンの文脈を扱えることと、安い単価で扱える範囲は別です。公式料金
このため、同じ会話へ資料を際限なく追加するより、作業に必要な情報を選ぶ設計が費用に影響します。ただし、文脈を削って再実行が増えれば逆効果です。実際の請求と品質を一緒に確認してください。
Muse Codeの契約とAPIは分けて考える
Muse EmberはMeta Model APIとMuse Codeで利用でき、公式資料ではMuse Codeの全サブスクリプションが対象です。ただし、サブスクリプションの枠はMuse Code用で、別途作成したAPIキーの呼び出しは従量課金です。モデルの提供範囲・Muse Codeの契約条件
すでにMuse Codeを契約している人は、まず既存枠で自分の作業を試す入口があります。APIで大量処理を組みたい人は、月額契約の枠を流用できると考えず、別予算として判断する必要があります。ほかのAIの定額プランに余裕があるなら、API単価が安いという理由だけで新しい契約を増やす必要はありません。
地域によって契約内容が異なると公式は案内しています。日本のアカウントでの新規契約可否、月額の表示額、日本語業務での品質は今回未確認です。「日本から誰でもこの料金で契約できる」「日本語でも海外評価と同じ結果になる」とは断定できません。
会社の資料を入れる前に確認すること
Meta Model APIのEmberはStandard modeのみで、入力や出力をMetaモデルの学習に使わないと説明されています。一方、Muse CodeのサブスクリプションではContributor modeが既定でオンとなり、データ利用の条件が異なります。同じモデル名でも、どこから使うかを確認してください。APIのデータ利用
Muse Codeでは設定からContributor modeをオフにできますが、設定は端末ごとです。複数PCで使う場合や、新しいPCで使い始める場合も確認が必要です。Muse Codeの設定
また、学習に使わないことと、データを保存しないことは別です。ゼロデータ保持は対象組織への別途有効化が必要で、標準で全利用者に付く条件ではありません。外部サービス経由の呼び出しには、そのサービスの取扱いも適用されます。Metaのゼロデータ保持の説明
最初に試すなら、今ある仕事を一つだけ切り出す
新モデルの評価は、全部の仕事を移す必要はありません。まず機密情報を除いた手元の例で、繰り返している処理を一つ選びます。
- 今のモデルでの正解率、費用、完了時間を残す。
- 同じ入力をEmberのmaxで処理し、出力を見比べる。
- 品質が足りる仕事だけ、effortを下げても問題ないか試す。
- 例外を人や上位モデルに戻す条件を決める。
Muse Emberは、賢さだけで主力を選ぶ場面より、必要な品質を保って処理回数を増やしたい場面で検討しやすいモデルです。評価上の安さを、自分の業務での成功1件あたりの費用へ置き換えて確認することが、導入判断につながります。
情報確認日:2026年11月11日。公開された公式資料と独立評価に基づく整理で、実機・APIの独自測定は行っていません。